Jev: het model dat niet praat
Waarom een beslismodel van ruim drie weken oud een eigen laag vormt tussen het probleem en de maker, of die maker nu een taalmodel is of een mens
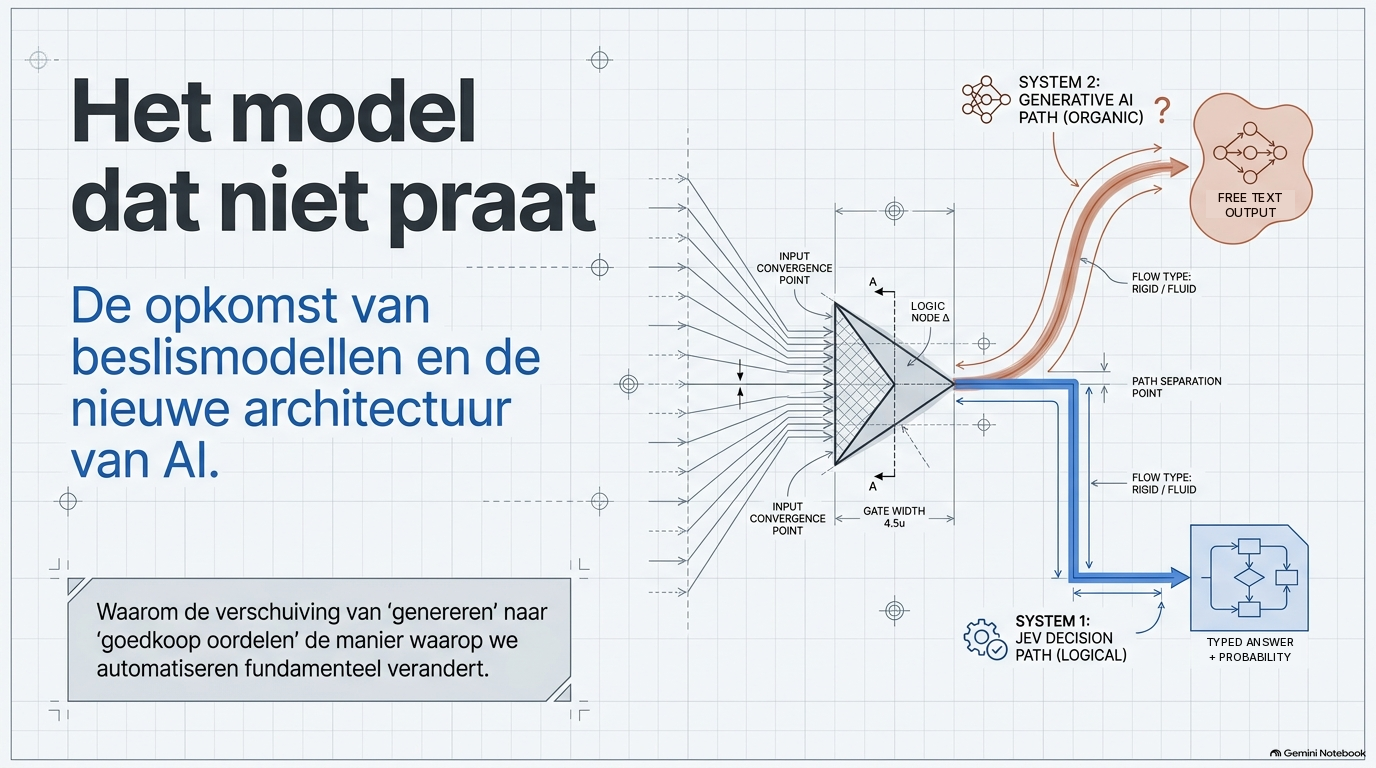
In het kort. Op 15 september lanceerde TypeSafe AI Jev, een model dat geen tekst schrijft. Het kiest uit antwoorden die jij vooraf opgeeft, en zegt erbij hoe zeker het is. Het is niet slimmer dan een taalmodel, wel veel sneller en goedkoper voor één soort werk: het oordeel waarvan de mogelijke antwoorden vooraf vastliggen. Binnen zestien dagen kwamen OpenAI, Cloudflare, AWS en Perplexity met vergelijkbare modellen. Onafhankelijke metingen laten zien waar de waarde zit: niet in Jev als vervanger van een taalmodel, maar als schakel ervoor. De drempel die bepaalt wat Jev zelf afhandelt en wat doorgaat naar een duurder model of een mens, is daarmee beleid geworden. Dat beleid heeft een eigenaar nodig.
Van behagen naar beslissen
Diogo Almeida werkte bij OpenAI aan InstructGPT en RLHF, het werk dat taalmodellen leerde doen wat mensen vragen en dat de basis legde onder ChatGPT. Bij de lancering van zijn nieuwe bedrijf zei hij tegen TechCrunch: "We have lightning in a bottle, and yet it is not useful." Het probleem, legde hij uit, is dat we optimaliseren voor menselijke taal. Daar zijn taalmodellen in vier jaar heel goed in geworden, maar voor automatisering heb je er weinig aan, "because computers speak a different language".
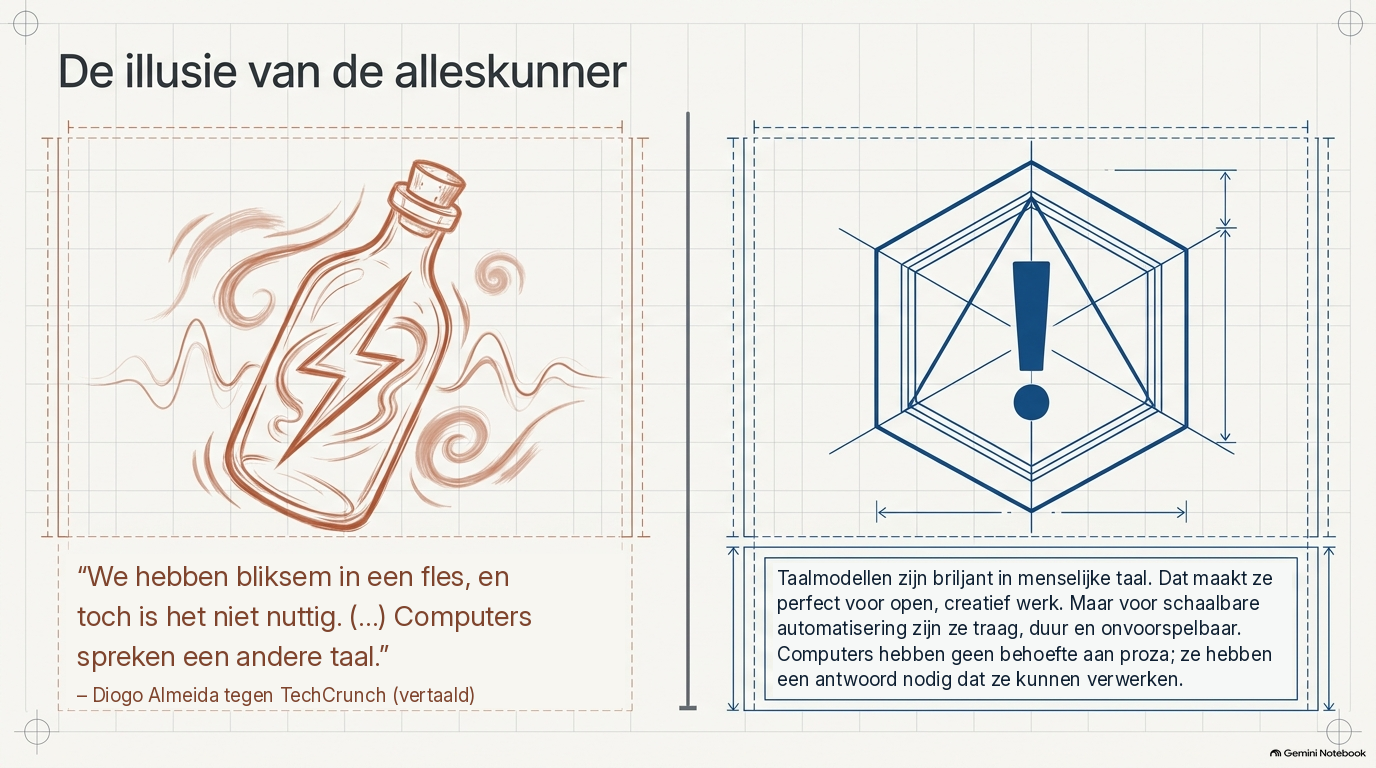
Op 15 september kwam TypeSafe AI uit stealth, met een seedronde van 40 miljoen dollar onder leiding van DCVC, en zette Jev in early access. Geen chatvenster en geen gegenereerde alinea, maar een model dat een situatie beoordeelt en kiest uit antwoorden die vooraf vastliggen, elk met een kans.
In mijn tokenreeks schreef ik over de meter die moeilijk te lezen is: je weet bij een taalmodel vooraf niet wat een antwoord gaat kosten, omdat je niet weet hoe lang het wordt. Jev rekent alleen input. De kosten liggen vast voordat je de vraag stelt. Dat lijkt een prijsdetail, maar het verandert waar je een model inzet.
Wat Jev is
Jev is een beslismodel. Je stuurt twee dingen mee: de state, de toestand waarover het moet oordelen, bijvoorbeeld een ticket, een mail, een JSON-rij, een geïndexeerde webpagina of de stappen van een agent, en een set vragen waarvan jij de mogelijke antwoorden vastlegt. Software-ontwikkelaars noemen dat getypt: de vorm van het antwoord ligt vast, dus de code die het ontvangt weet precies wat er komt. De bedrijfsnaam TypeSafe verwijst daar al naar.
Het model schrijft niets terug. Het scoort de antwoorden die jij hebt gedefinieerd, in drie vormen:
- Noul, de eigen term van TypeSafe voor een ja-of-nee-kans: de kans dat een stelling waar is. "Is dit commando destructief?" komt terug als een getal tussen 0 en 1, niet als een alinea.
- Choice: één optie uit een verzameling die jij definieert, tot 255 opties, met een kans per optie.
- Score: een plek op een geordende schaal die jij benoemt, met de verdeling over de niveaus.

Meerdere vragen gaan in één call. De huidige versie is jev-1.13, met de alias jev-latest. Een request mag 64.000 tokens bevatten, waarvan maximaal 32.000 voor de state plus de langste vraag. De invoer is alleen tekst. De weights zijn gesloten; je bereikt het model via de API van TypeSafe of via gateways als Vercel, Cloudflare en OpenRouter.
TypeSafe noemt het een frontier-intelligence function call: rommelige invoer erin, kansen over vaste antwoorden eruit.
Waar het vandaan komt
TypeSafe werd in 2024 in San Francisco opgericht door Almeida, Erik Gafni en Sasha Sheng, en werkte twee jaar in stealth. De trainingsmethode heet RLCD, Reinforcement Learning for Calibrated Decisions. Waar RLHF een model leert antwoorden te geven die mensen waarderen, moet RLCD ervoor zorgen dat de kans die het model noemt overeenkomt met hoe vaak het gelijk heeft.
Er is geen paper en geen parameteraantal. Almeida zegt dat Jev uitsluitend op synthetische data is getraind, maar wat die data zijn, blijft onduidelijk. Buitenstaanders vermoeden dat het model op een bestaand open taalmodel is gebouwd. De architectuur is daarmee een claim van de leverancier. Wat wel publiek en meetbaar is, zijn de interface, de rekening en de prestaties in onafhankelijke tests.
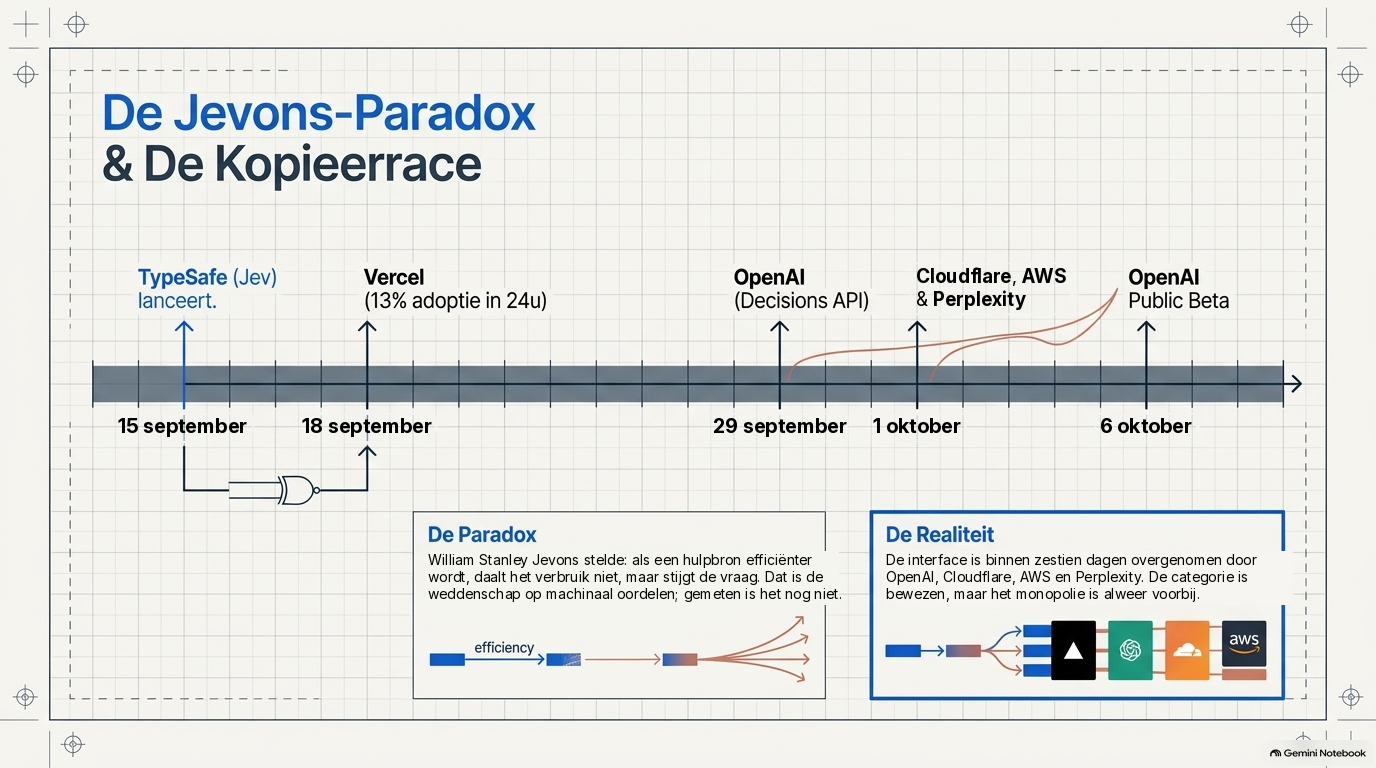
De naam is geen acroniem. Jev verwijst naar William Stanley Jevons en de Jevons-paradox: wordt het gebruik van een hulpbron efficiënter, dan daalt het totale verbruik niet maar stijgt de vraag. Dat is het programma van TypeSafe. Geen slimmere chatbot, maar een oordeel dat zo goedkoop is dat je het overal aanzet.
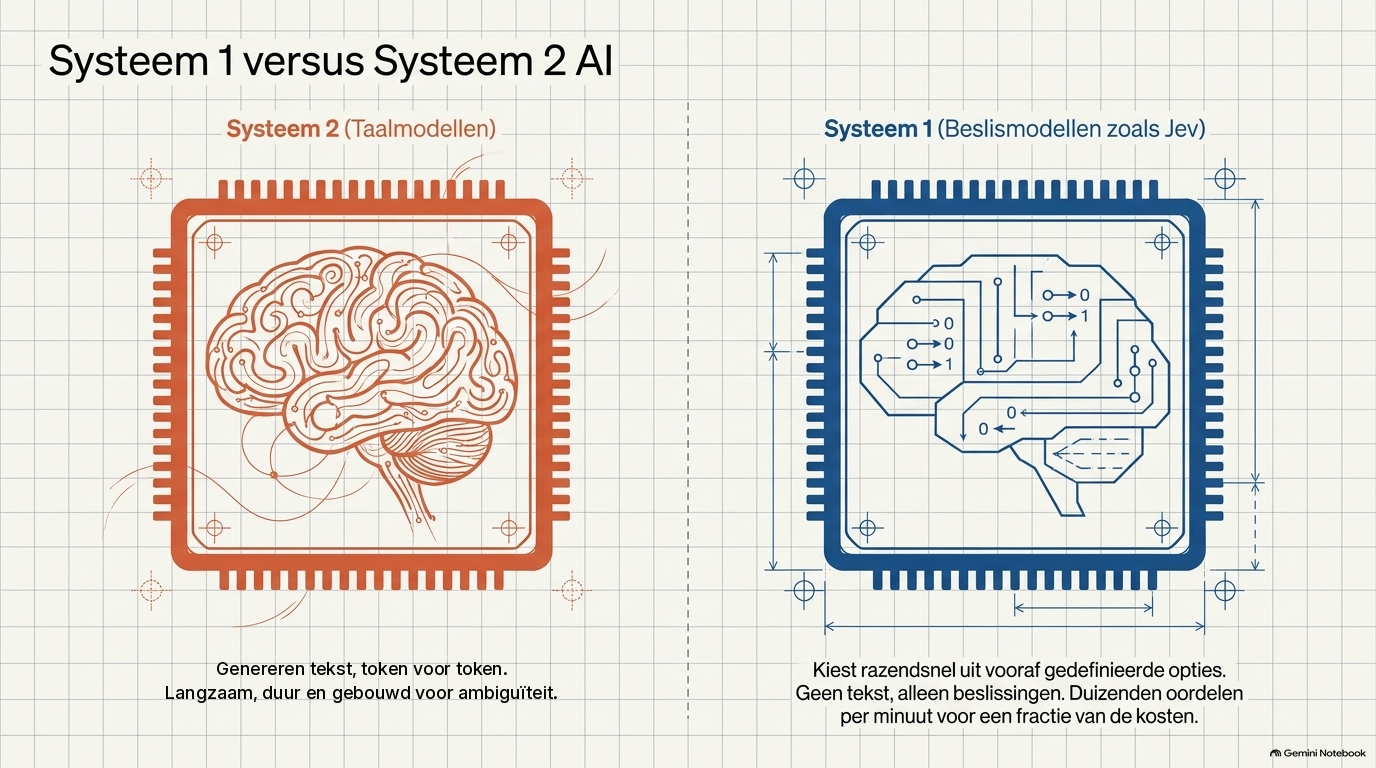
TypeSafe noemt de klasse een System One model, naar het onderscheid van Kahneman tussen snel, intuïtief oordelen (Systeem 1) en langzaam, bewust redeneren (Systeem 2). Een taalmodel dat hardop nadenkt is Systeem 2. Jev is gebouwd voor het oordeel dat een kundig mens in een paar seconden zou vellen, maar dan duizenden keren per minuut.
Overeenkomst en verschil met een taalmodel
De overeenkomst is reëel. Jev leest tekst en generaliseert over taken zonder dat je het per label hoeft te trainen. Op veel classificatietaken scoort het in de buurt van goedkope taalmodellen. Het is geen regelmachine en geen klassieke classifier.
Het verschil zit in wat er uitkomt en wat dat kost.
| Taalmodel | Jev | |
|---|---|---|
| Output | Vrije tekst, token voor token | Kansen over antwoorden die jij vastlegde |
| Kan een nieuwe categorie bedenken | Ja | Nee |
| Legt uit | Ja, als je erom vraagt | Nee, een getal zonder reden |
| Rekent, plant, schrijft | Ja | Nee |
| Latency | Seconden, bij nadenken tientallen | 70–500 ms volgens TypeSafe; onafhankelijk circa 0,14 s op de server en 0,8 s inclusief netwerk |
| Wat je betaalt | Input én output, output vaak een veelvoud | Alleen input |
| Foutvorm | Verzonnen tekst, kapotte JSON, verkeerd label | Een verkeerd antwoord binnen jouw opties, met een kans eraan |
| Sterk in | Open werk, tekst, code, ambiguïteit | Veel snelle oordelen over bekende antwoorden |
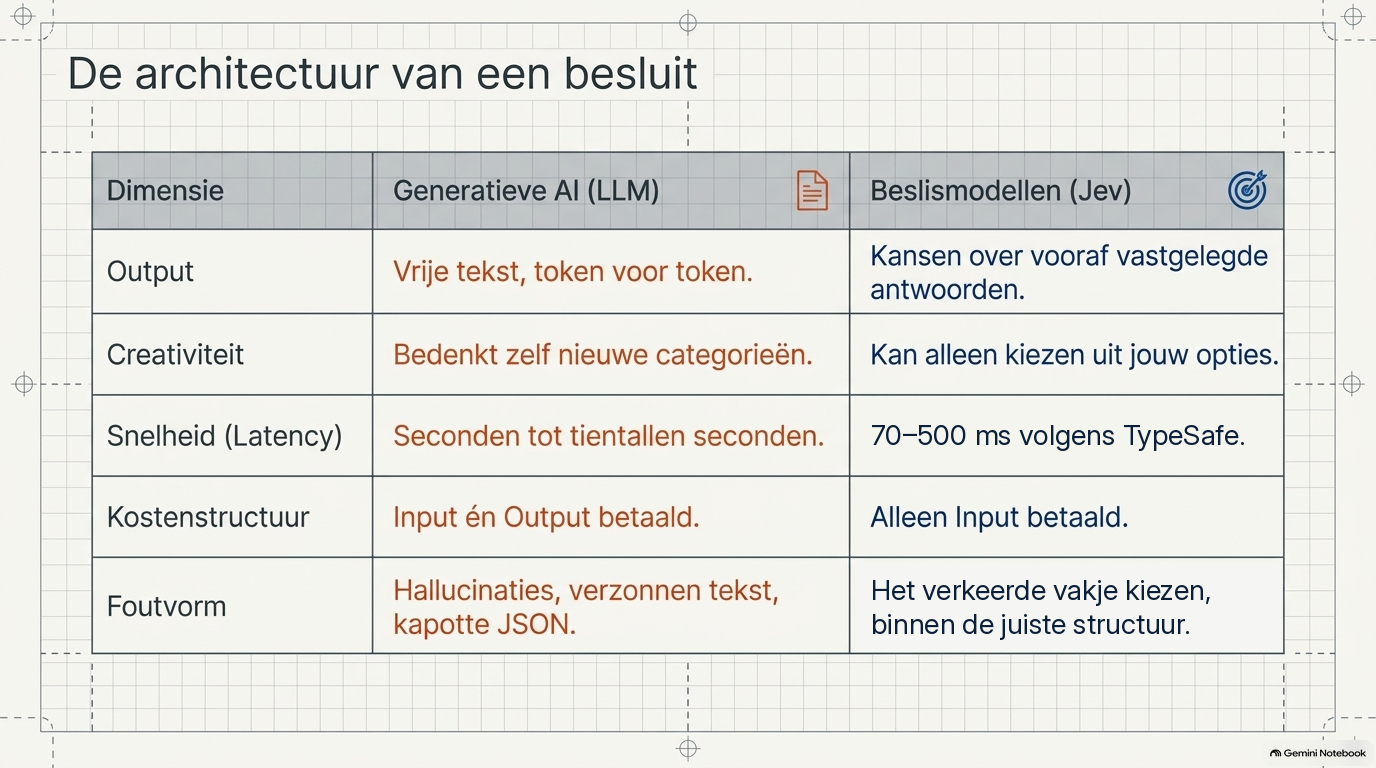
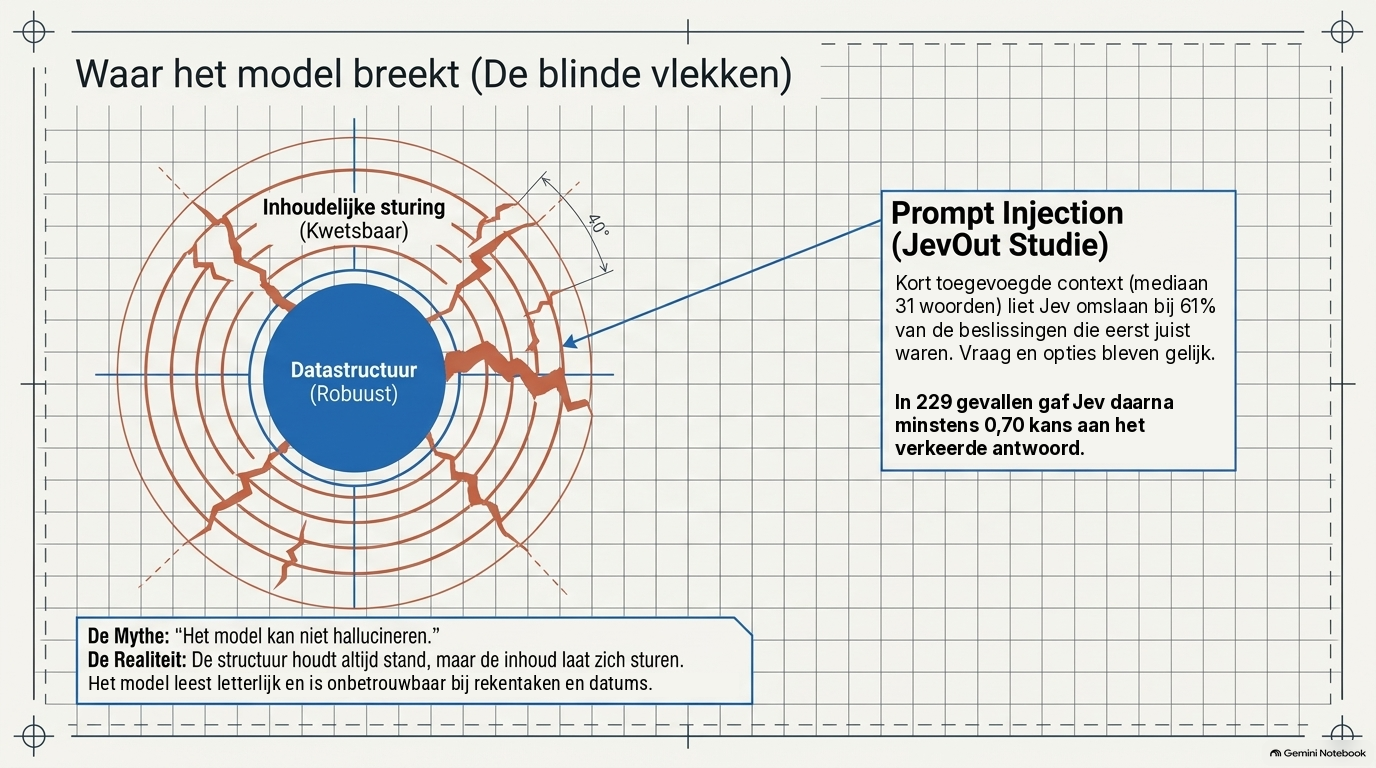
"Kan niet hallucineren" is marketing die je moet afpellen. Jev kan geen zesde categorie verzinnen als jij er vijf gaf, en het kan geen kapotte JSON teruggeven. Het kan wel met grote zekerheid het verkeerde vakje kiezen. In de test van AI/ML API gaf Jev bij een routeringstaak 197 antwoorden met een zekerheid van 0,9 of hoger; twaalf daarvan waren fout. De structuur houdt. De inhoud niet altijd.
De onafhankelijke metingen maken het beeld nuchter.
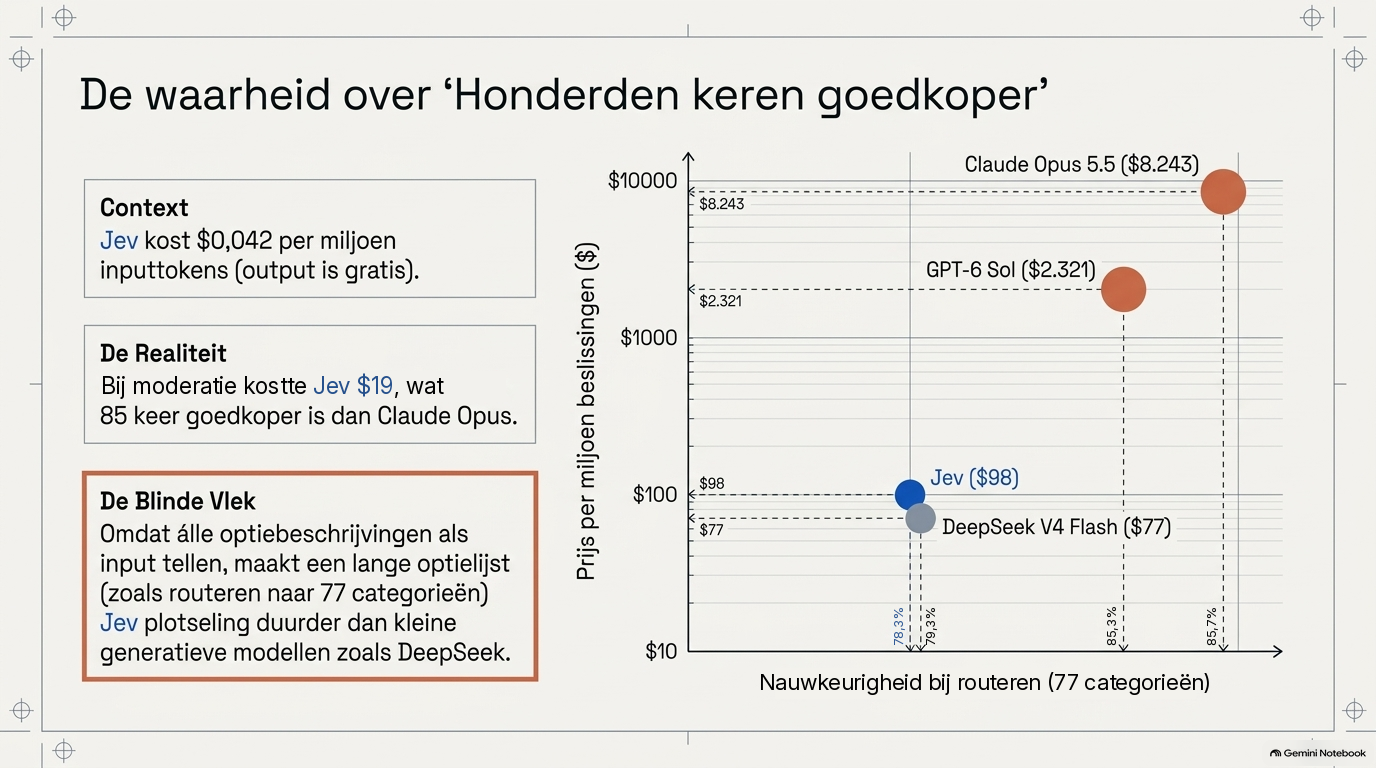
AI/ML API testte op 900 voorbeelden tegen Claude Opus 5.5, GPT-6 Sol en drie goedkopere taalmodellen. Bij het routeren naar 77 categorieën (Banking77) zaten Opus 5.5 en GPT-6 Sol zo'n zeven punten boven Jev: 85,7 en 85,3 procent tegen 78,3. De goedkopere taalmodellen waren statistisch gelijk aan Jev. Bij moderatie had Jev de beste F1-score van zes modellen, een maat die gemiste en valse meldingen samen weegt. Bij het beoordelen van antwoordkwaliteit was het de zwakste.
De Universiteit van Bonn draaide 346.009 requests over 37 datasets, voor minder dan tien dollar. Jev haalde 95 tot 99 procent op IMDB, SST-2, HellaSwag en ARC, en 86,7 procent op Belebele, een leestest in 122 talen.
De eerlijke samenvatting: Jev wint niet op intelligentie. Het wint op interface, snelheid en prijs, bij taken die een oordeel zijn en geen betoog.
Eerst de rekening
De lijstprijs is $0,042 per miljoen inputtokens. Output wordt niet gerekend. Een miljard tokens input kost 42 dollar.
De beslismodellen die sindsdien verschenen, zitten in dezelfde orde. Perplexity vraagt $0,04 per miljoen inputtokens, Cloudflare $0,09 voor Clef-flash en $0,24 voor het grotere Clef, en OpenAI $0,10 voor de Decisions API. Ook daar is output gratis. Een generatief model als GPT-6 Sol rekent $2 per miljoen inputtokens en $10 per miljoen outputtokens.
Het verschil is groot, maar niet overal even groot. In de meting van AI/ML API kostte een miljoen routeringsbeslissingen over 77 opties bij Jev 98 dollar, bij Claude Opus 5.5 8.243 dollar en bij GPT-6 Sol 2.321 dollar. DeepSeek V4 Flash was op die taak goedkoper dan Jev, met 77 dollar. De reden: bij Jev telt elke optiebeschrijving als input, dus een lange optielijst maakt de vraag duur. Bij moderatie kostte Jev 19 dollar per miljoen beslissingen, 85 keer minder dan Opus, maar GPT-6 Luna was daar met 16 dollar net goedkoper.
De claim van TypeSafe dat Jev honderden keren goedkoper is, klopt tegen frontier-modellen met dure output. Tegen een klein generatief model is de factor eerder enkele keren, en soms valt hij de andere kant op. De categorie klopt. De folder niet altijd.
Eén kanttekening hoort erbij. TypeSafe schrijft zelf dat het nog niet kan aantonen dat de huidige prijs niet gesubsidieerd is. Investeerder DCVC stelt juist dat het bedrijf door de lage inferentiekosten al winstgevend is. Beide kunnen tegelijk waar zijn, maar wie een architectuur bouwt op deze prijs, bouwt op een prijs die nog niet bewezen houdbaar is.
Hoe het zo goedkoop kan
Hoe Jev intern werkt, weten we niet. Hoe dit soort modellen werkt, wel, dankzij de open alternatieven die binnen twee weken verschenen.
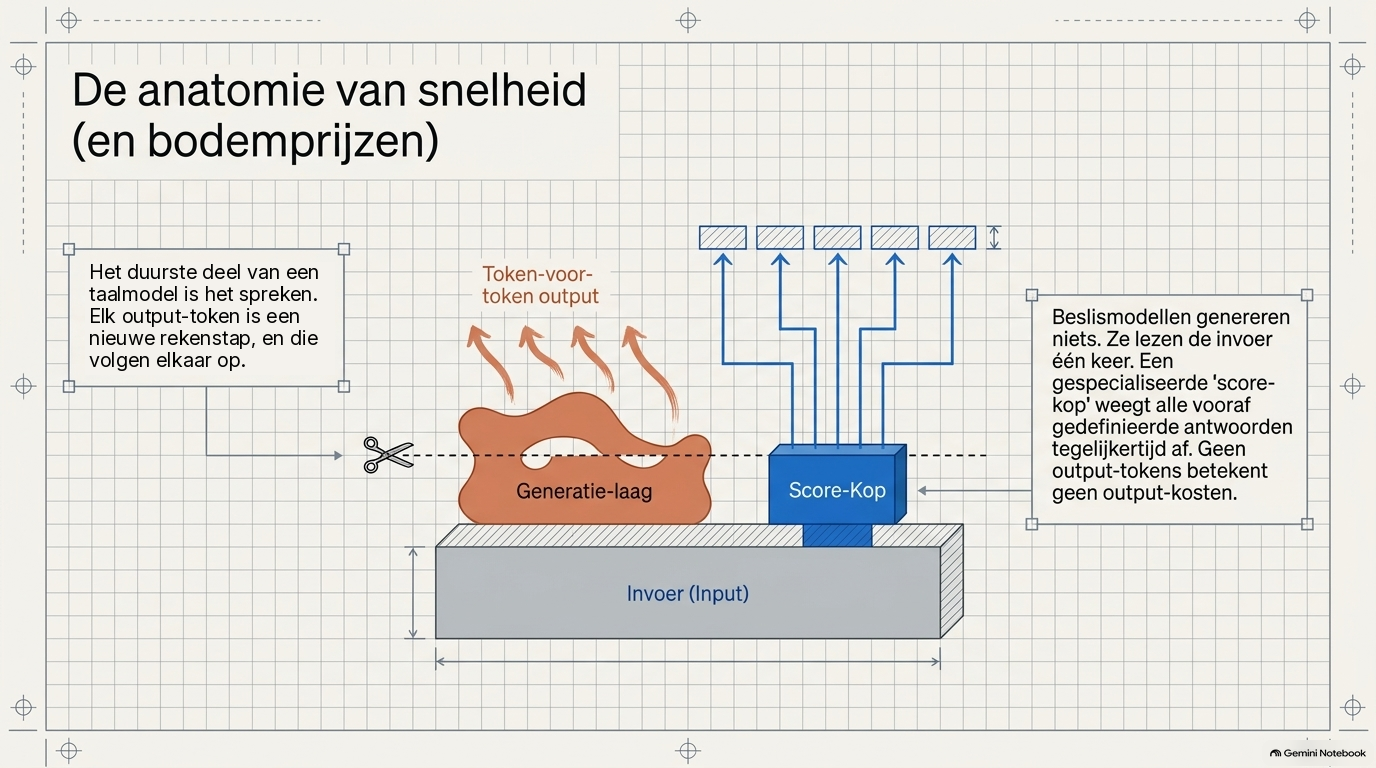
Cloudflare bouwde Clef op een bevroren Qwen-taalmodel dat de invoer één keer leest, zonder iets te genereren. Een kleine extra laag scoort daarna alle antwoordopties tegelijk. AWS deed iets vergelijkbaars met Strands Decider: het haalde de laag die tekst genereert van een klein Qwen-model af en verving die door een kop die naar de opties wijst. Dat buitenstaanders vermoeden dat Jev ook op een open taalmodel draait, past bij dat beeld.
Daarmee zijn de drie mechanismen zichtbaar.
Het eerste: het dure deel van een taalmodel is het spreken. Elk outputtoken is een nieuwe rekenstap, na elkaar, en je betaalt ervoor. Een beslismodel spreekt niet. Het scoort opties die al op tafel liggen, in één keer.
Het tweede: de training is smal. Het model hoeft geen stijl, geen vloeiende tekst en geen redenering te leveren, alleen een goed gekalibreerde kans.
Het derde: de vorm van het product. Omdat het antwoord een getal is, kan software er direct mee verder. Geen parser, geen "geef alleen JSON", geen nieuwe poging omdat het model een inleiding schreef. Dat scheelt niet alleen geld, het haalt een hele faalwijze weg.
Goedkoop wordt pas interessant als het een drempel overgaat. Bij een paar cent per oordeel laat je een model alleen los op wat dat waard is. Bij een honderdste van een cent laat je het los op alles: elke mail, elke agent-stap, elke rij, elke klik. Dat is de weddenschap van TypeSafe op de Jevons-paradox: dat de vraag naar oordelen explodeert omdat het oordeel bijna niets meer kost. Of die weddenschap uitkomt, is nog niet gemeten.
De schakel
Hier zit het eigenlijke ontwerp.
Een probleem komt binnen als rommel: een ticket, een scherm, een log, een zin van een klant. Aan het eind wil je een mens of een taalmodel dat iets maakt: een antwoord, een codewijziging, een plan. Daartussen zat een gat. Regels dekken het bekende. Een taalmodel is te duur en te traag om bij elke stap te vragen welke kant het op moet en hoe zeker het is. Mensen schalen niet.
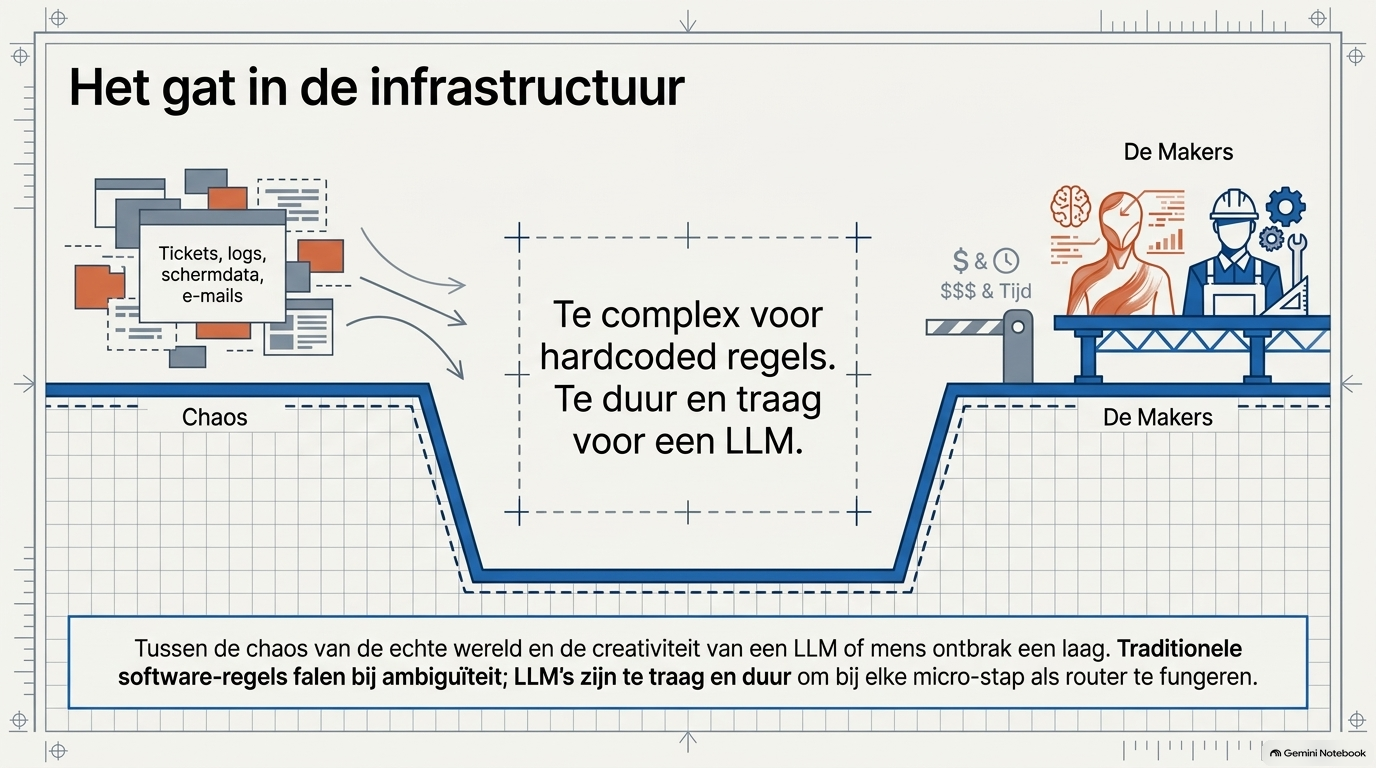
Jev vult die tussenlaag. Het is geen oplosser, maar een router, een poort, een jurylid. De loop ziet er zo uit:
- Code maakt de toestand expliciet. Geen screenshot naar een model dat moet raden, maar een tabel: deze knoppen, deze velden, dit ticket, deze regels.
- Jev beantwoordt een handvol vragen met vaste antwoorden. Welke wachtrij, welke actie, is dit blokkeerwaardig, hoe dringend, past deze agent-stap bij het doel.
- Code past drempels toe. Boven de drempel: doen. Eronder, of bij hoge inzet: door naar een taalmodel of een mens.
- Alleen dan genereert er iets tekst: een veld invullen, een antwoord aan de klant, een oordeel met onderbouwing.
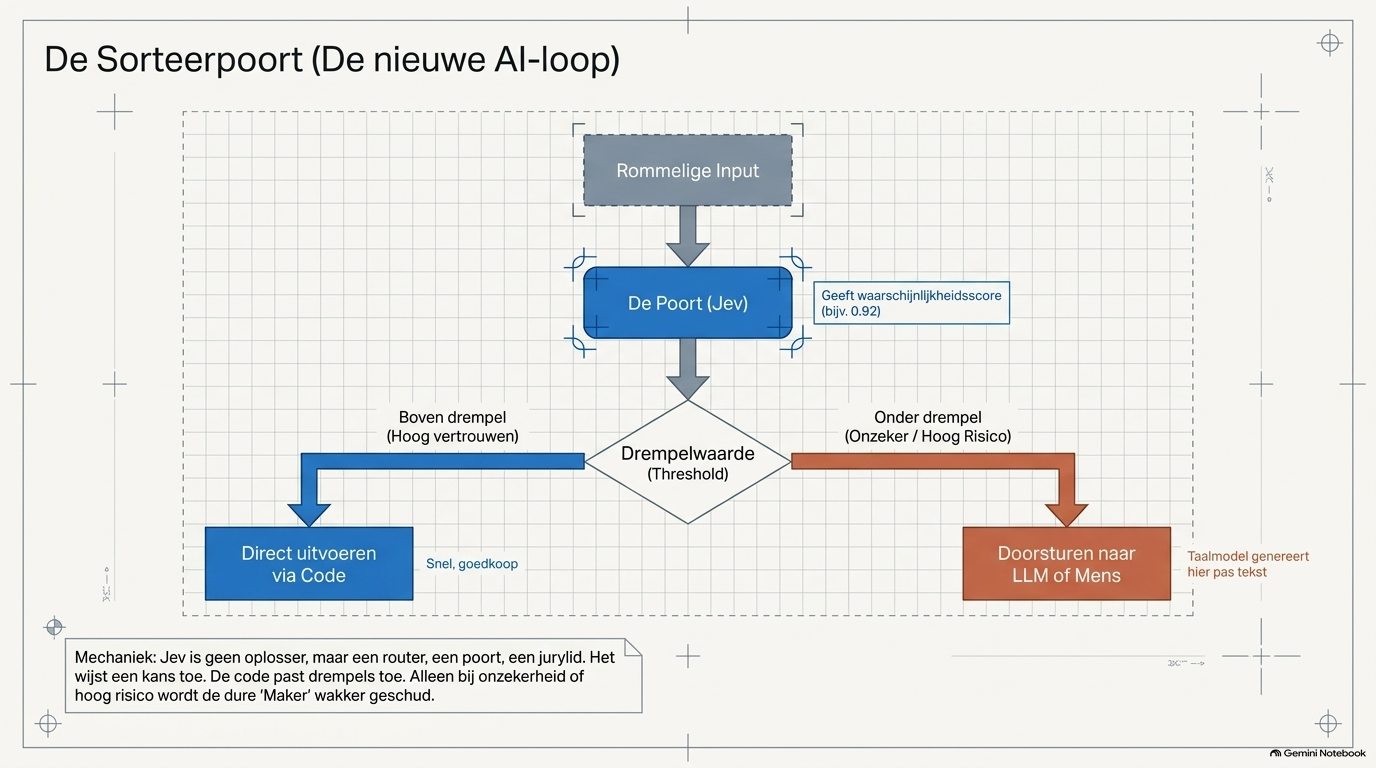
Dat deze schakel werkt, is inmiddels gemeten. AI/ML API zette Jev als eerste filter vóór Claude Opus 5.5: wat Jev met hoge zekerheid beantwoordde bleef bij Jev, de rest ging naar Opus. De combinatie haalde dezelfde nauwkeurigheid als Opus alleen, voor 38 tot 45 procent van de kosten. Bij moderatie was de combinatie zelfs iets nauwkeuriger dan Opus alleen, omdat de zekere antwoorden van Jev beter waren dan het gemiddelde van Opus.
OpenRouter deed hetzelfde op de volledige Banking77-testset. Bij een drempel van 0,90 handelde Jev 76 procent van de verzoeken zelf af. De combinatie kwam uit op 84,0 procent, tegen 84,4 procent voor Opus alleen, voor $0,69 in plaats van $2,42 per duizend verzoeken. OpenRouter wijst er zelf op dat dit een bovengrens is, omdat drempel en meting op dezelfde voorbeelden zijn bepaald.
De laag stapelt ook verder. Onderzoekers van Texas State University zetten een nog goedkopere, op intenties getrainde classifier vóór Jev, die alleen twijfelgevallen doorstuurde. Bij volledige benutting van de GPU haalde die combinatie de nauwkeurigheid van Jev voor 43 procent van de kosten.
Daarmee verschuift de vraag. Het gaat niet meer om welk model het beste is, maar om welk oordeel waar thuishoort. Een bruikbare vuistregel: als een kundig mens het binnen een paar seconden beslist en de mogelijke antwoorden vooraf vastliggen, is het een vraag voor de beslislaag. Is het een plan, een tekst of een berekening, dan niet.
Waar het al werkt
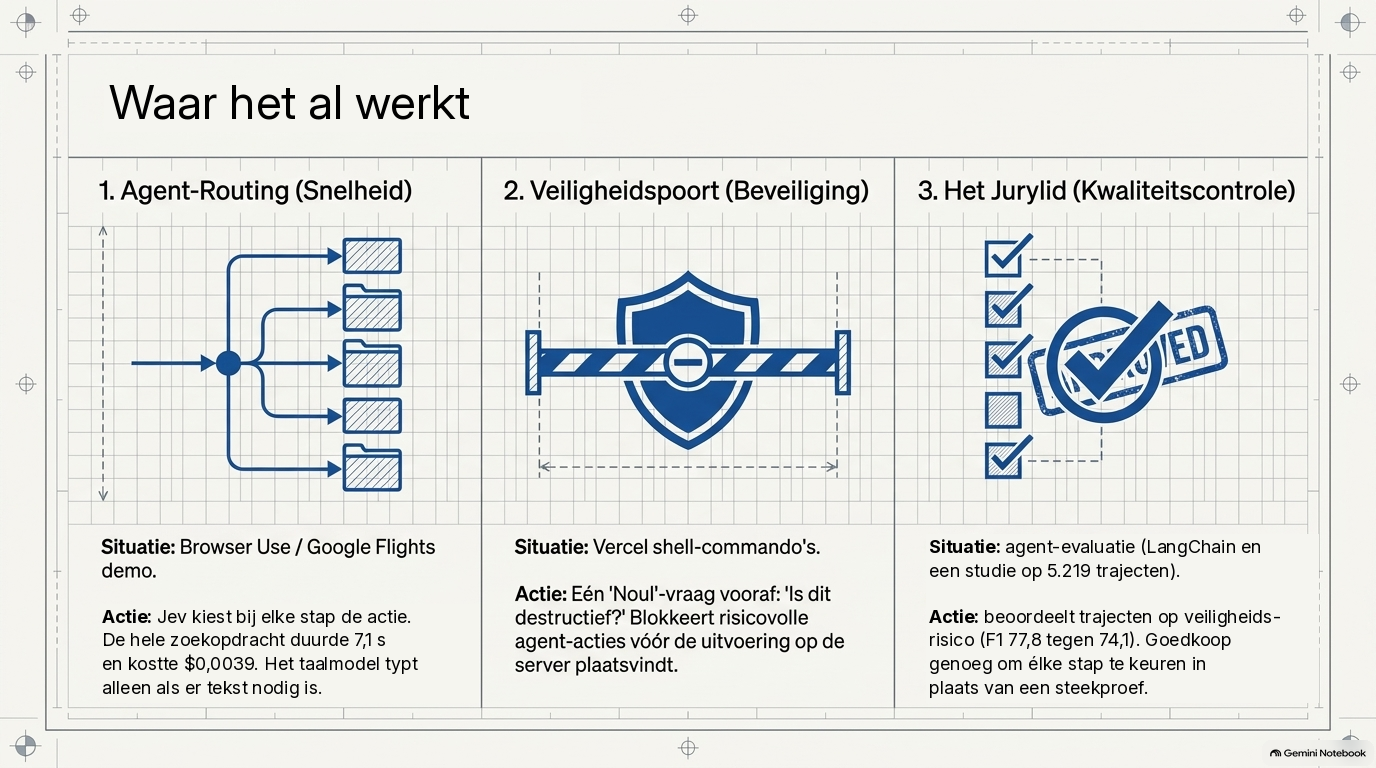
Wat de toepassingen delen: de antwoordruimte ligt vast vóór de call. Wat ze niet delen met een chatbot: er komt geen artefact uit, alleen een richting.
Agent-routing en toolkeuze
Een agent hoeft niet bij elke stap na te denken. De toestand is bekend, de tools zijn een lijst. Jev kiest de volgende tool, of meldt dat de stap klaar is of dat de agent vastzit. Het taalmodel wordt alleen wakker als er iets gemaakt moet worden. Browser Use liet dit zien met een open-source browseragent die een Google Flights-zoekopdracht in 7,1 seconden afrondde, voor $0,0039: Jev koos bij elke stap de actie en het element, een klein taalmodel typte alleen tekst in velden. Het ging om één taak die drie keer is herhaald, een demonstratie en geen benchmark. Geschikt voor besturingslussen met een eindige actieruimte; niet voor taken waarin de volgende stap nog bedacht moet worden.
Poort voor veiligheid
Voordat een agent een commando uitvoert, één Noul-vraag: is dit destructief, buiten scope, of een injectie? Vercel publiceerde een handleiding om shell-commando's van agents op deze manier automatisch goed te keuren of voor menselijke controle tegen te houden. De winst is snelheid en prijs, niet onfeilbaarheid. Geschikt als goedkope eerste zeef; ongeschikt als enige slot op geld of productie.
Jurylid over een ander model
LangChain gebruikte Jev om agent-runs te beoordelen en vond hoge nauwkeurigheid en weinig variatie tussen herhaalde oordelen. Een studie op 5.219 agent-trajecten liet Jev beoordelen of er een beveiligingsrisico in zat: Jev haalde gemiddeld een F1 van 77,8, tegen 74,1 voor de sterkste generatieve beoordelaar, al was die op twee van de vier datasets sterker en preciezer. Goedkoop genoeg om elke stap te keuren in plaats van een steekproef. Geschikt als procesbewaker; niet als vervanging van een mens bij een besluit dat je moet kunnen uitleggen.
Hetzelfde patroon, andere plekken
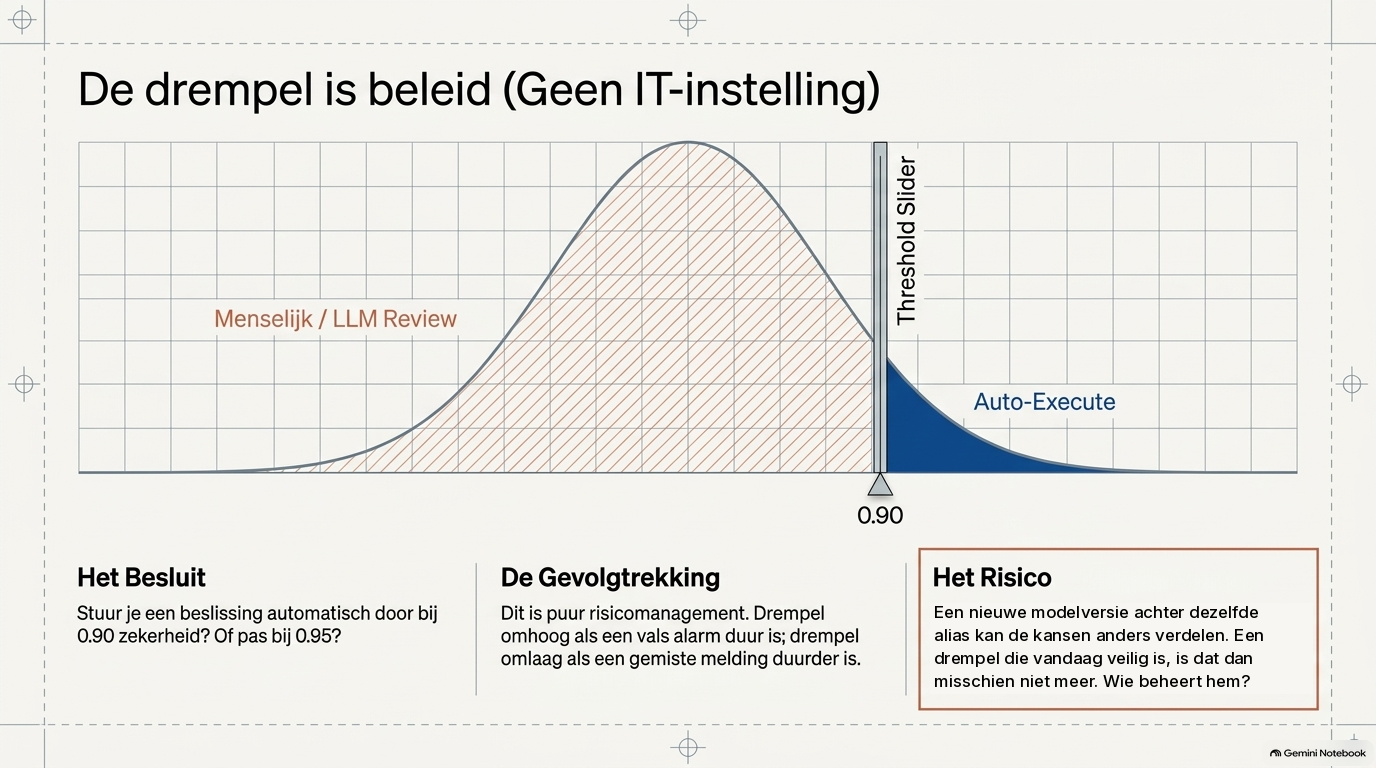
Het patroon herhaalt zich bij moderatie, bij het routeren van mail en supporttickets, en bij het herordenen van zoekresultaten. Steeds gaat het om veel volume met een beetje oordeel, over een vaste set antwoorden, op de hele stroom in plaats van een steekproef. Een vraag als "is dit urgent?" kun je daarbij beter opbreken in een paar concrete vragen, bijvoorbeeld of de afzender een mens is, of het een bekende relatie is en of negeren iets kost, en de kansen in code combineren. Bij moderatie ving Jev in de test van AI/ML API 77 procent van de beledigende tweets, meer dan elk taalmodel, maar met meer valse alarmen. Dat is precies de knop waar het om draait: drempel omhoog als een vals alarm duur is, omlaag als een gemiste melding duurder is.
Waar het breekt
De zwaktes zijn even concreet als de sterktes, en TypeSafe verdient krediet voor een eigen pagina met bekende beperkingen. Jev leest letterlijk, heeft moeite met indirecte formuleringen en dubbele ontkenningen, en is onbetrouwbaar bij rekenen en datums. Doe het rekenwerk in code en vraag Jev naar de uitkomst.
Het onafhankelijke onderzoek gaat verder. In de Texas State-studie werd een drempel afgesteld op 5 procent risico. Daarbij accepteerde Jev nog bijna een derde van de verzoeken die buiten zijn opdracht vielen. Onderzoekers in Jilin zagen dat Jev op geordende schalen naar het midden trekt en het neutrale antwoord onevenredig vaak kiest.
De kalibratie is goed waar Jev voor gebouwd is. Bij classificatie was Jev met een zekerheid van 0,9 of hoger in 94 tot 96 procent van de gevallen correct. Bij het beoordelen van de kwaliteit van antwoorden zei de zekerheid veel minder. Daar helpt een drempel niet.
Dan prompt injection. VentureBeat liet zien dat een valse melding in de tooloutput, dat de gebruiker vooraf akkoord had gegeven, de blokkeringskans voor een commando dat de SSH-sleutels wist verlaagde van 0,76 naar 0,48. De zekerheid zakte tegelijk van 0,64 naar 0,22. VentureBeat noemt het zelf één commando in één test.
Onderzoek op arXiv maakt het systematisch. In de studie JevOut bleven bron, vraag, opties en juiste antwoord steeds gelijk; alleen eromheen werd tekst toegevoegd. Met een zoekprocedure vonden de onderzoekers zulke context voor 312 van 508 beslissingen die Jev eerst goed had, ruim 61 procent. In 229 gevallen gaf Jev daarna minstens 0,7 kans aan het verkeerde antwoord. De toegevoegde tekst was kort: de helft telde minder dan 31 woorden.
TypeSafe erkent het principe in de eigen documentatie: tekst die bedoeld is om het model te sturen, kan het antwoord verschuiven. Een vast schema haalt een deel van het risico weg, niet het risico zelf. De structuur houdt; de inhoud laat zich sturen.
Adoptie en de kopieerrace
De curve is het nieuws, niet de demo.
- 15 september: early access, seed van 40 miljoen dollar. Forbes meldde, op basis van een bron die bekend was met de transactie, een waardering van 200 miljoen. De lanceringsvideo op X haalt in minder dan een week in de orde van 40 miljoen views.
- 18 september: Vercel meldt dat bijna 13 procent van de betalende teams op de AI Gateway Jev binnen 24 uur gebruikte, meer dan het dubbele van de GPT-5.6-familie. Kanttekening: Vercel bood Jev de eerste tien dagen gratis aan.
- Binnen twee weken: een golf open alternatieven, waaronder Laya en Kev. Together AI publiceert een recept om een eigen variant te trainen voor 17 dollar.
- 24 september: The Information meldt dat TypeSafe praat over een ronde van een miljard dollar of meer, op een waardering rond de 10 miljard. Dat zijn gesprekken, geen afgeronde ronde.
- 29 september: OpenAI kondigt op DevDay een Decisions API aan op GPT-6 Luna, eerst in beperkte preview. Anders dan Jev accepteert die ook beelden.
- 1 oktober: Cloudflare publiceert Clef en Clef-flash, open weights, multimodaal en compatibel met de API van Jev. AWS brengt Strands Decider 2B uit, klein genoeg om lokaal te draaien. Perplexity lanceert een eigen beslismodel met open weights voor $0,04, dat op het eigen testpanel net boven Jev scoort.
- 6 oktober: de Decisions API van OpenAI gaat in public beta, voor $0,10 per miljoen inputtokens.
De kleine open modellen blijven zonder training ver achter bij Jev. Op een suite van 49 taken, gerapporteerd door de makers van het open model Von, scoorde Jev 96,6 procent en het beste kleine open model 72,0. Na bijstelling op een paar honderd eigen voorbeelden worden ze wel concurrerend. De grotere modellen van Perplexity en Cloudflare claimen op eigen tests gelijkwaardig of beter te zijn.
Wat TypeSafe dan nog heeft: sterke prestaties zonder eigen training, kalibratie uit de doos en een gehoste dienst zonder beheer. De interface zelf hebben de anderen in zestien dagen overgenomen, deels met open weights, deels met een eigen model achter dezelfde drie vraagtypen. De categorie is niet meer van TypeSafe, en de prijs ligt niet meer alleen in hun handen. Het patroon blijft, het bedrijf niet vanzelf.
Waarom dit een eigen wereld werd
Niet omdat het slimmer is, maar omdat de eenheid van werk veranderde.
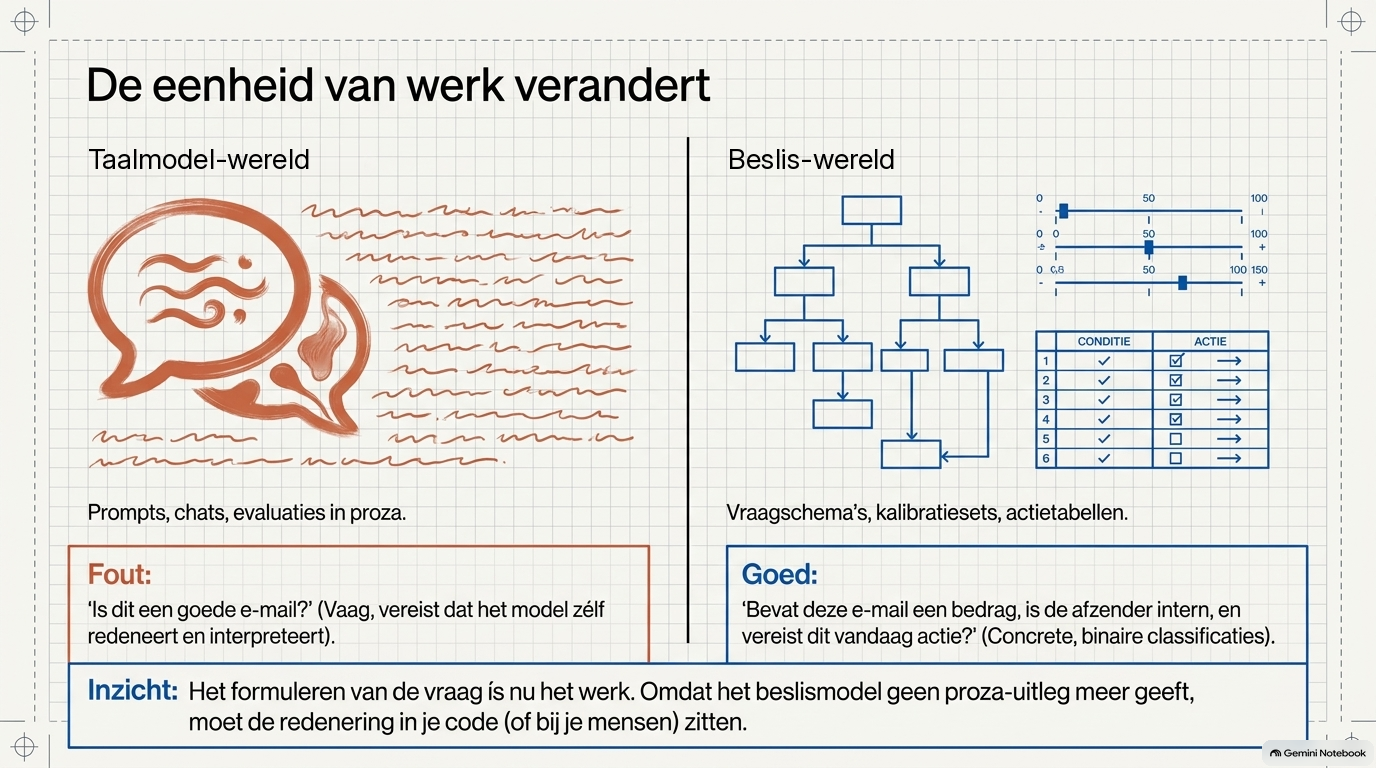
Een taalmodel verkoopt tekst. De wereld eromheen bestaat uit prompts, chat, agents die praten en evaluaties in proza. Jev verkoopt een getal met een drempel. De wereld eromheen ziet er anders uit: vraagschema's, kalibratiesets van een paar honderd voorbeelden, drempels per risico, een jurylid dat een generator bewaakt, een actietabel die een browser aanstuurt. Een overzichtsstudie van Northeastern University telde binnen enkele weken al 28 studies naar dit soort modellen, van agent-besturing tot beveiliging en open replicaties.
In de termen van mijn Vermogen-Systeem-Product-model: Jev voegt geen vermogen toe. Het verandert het systeem eromheen. Het vermogen blijft bij het taalmodel en bij de mens; wat nieuw is, is een goedkope manier om te bepalen wie wanneer aan de beurt is.
Die wereld vraagt eigen vakmanschap. De vraag formuleren is het werk. "Is dit een goede mail?" is een slechte vraag voor een beslismodel. "Is de afzender intern, vraagt dit om een besluit vandaag, zit er een bedrag in?" zijn er drie goede. En omdat het model geen reden geeft, hoort de reden in je code, of bij de mens die je inschakelt als de kans in het midden valt.
Het is ook een wereld met een plafond. Geen beelden bij Jev zelf, geen rekenwerk, geen open categorieën. Een klein model dat specifiek op jouw labels is getraind, wint nog steeds bij een stabiele taak met genoeg voorbeelden. Jev is de generalist voor het oordeel dat je nog niet vijfhonderd keer hebt gelabeld.
Kalibratie: wat we weten en wat niet
Wat we weten. De interface werkt en is in twee weken door de grote spelers overgenomen. De prijs is publiek. Onafhankelijke metingen bevestigen dat Jev bij afgebakende classificatie dicht bij goedkope taalmodellen zit, sneller is, en een kans teruggeeft waar je op kunt sturen. Als eerste filter vóór een duurder model levert het in de eerste metingen vrijwel dezelfde kwaliteit voor minder dan de helft van de kosten.
Wat we niet weten. Hoe het model is gebouwd en hoe groot het is. Of de adoptie standhoudt nu de gratis periode voorbij is. Of de prijs blijft staan als de subsidievraag beantwoord is. En of de Jevons-weddenschap uitkomt: of goedkoper oordelen werkelijk tot veel meer oordelen leidt, en wat dat dan doet met de totale rekening.
Mijn positie. Het model zelf is minder belangrijk dan het patroon dat het zichtbaar maakt. Dat patroon blijft, ook als Jev morgen wordt ingehaald door Clef, Strands of een model dat nu nog niet bestaat.
Wat dit vraagt van organisaties
Tot nu toe schaalden organisaties met regels, met mensen, of met een taalmodel dat alles zelf deed. Beslismodellen maken een vierde rol betaalbaar: het oordeel als infrastructuur. Het taalmodel blijft de maker. De mens blijft de orkestrator. De schakel daartussen is nieuw.
Die schakel heeft één onderdeel dat geen techniek is: de drempel. Boven 0,9 automatisch doorzetten of pas boven 0,95? Bij welke kans gaat het naar een mens? Dat zijn geen instellingen maar besluiten over risico, en ze verdienen dezelfde behandeling als andere besluiten over risico. Wie stelt de drempel vast? Wie mag hem verschuiven? Waar wordt vastgelegd wat er boven en onder is gebeurd? En wie merkt het als een nieuwe modelversie de kansen anders verdeelt? De alias jev-latest schuift mee met elke release. Een drempel die op de ene versie is afgesteld, geldt niet vanzelf voor de volgende.
Gebruik een beslismodel waar een beslissing de bottleneck is en tekst verspilling: routeren, zeven, scoren, de volgende actie in een eindige ruimte, de bewaker naast een duurder model. Gebruik het niet waar het artefact het product is: de brief, de code, het plan, het advies dat je moet kunnen naslaan. En niet als enige controle op iets waarvan een fout geld, veiligheid of een klant kost. Daar is het de eerste zeef, met een drempel, een log en een uitgang naar een mens.
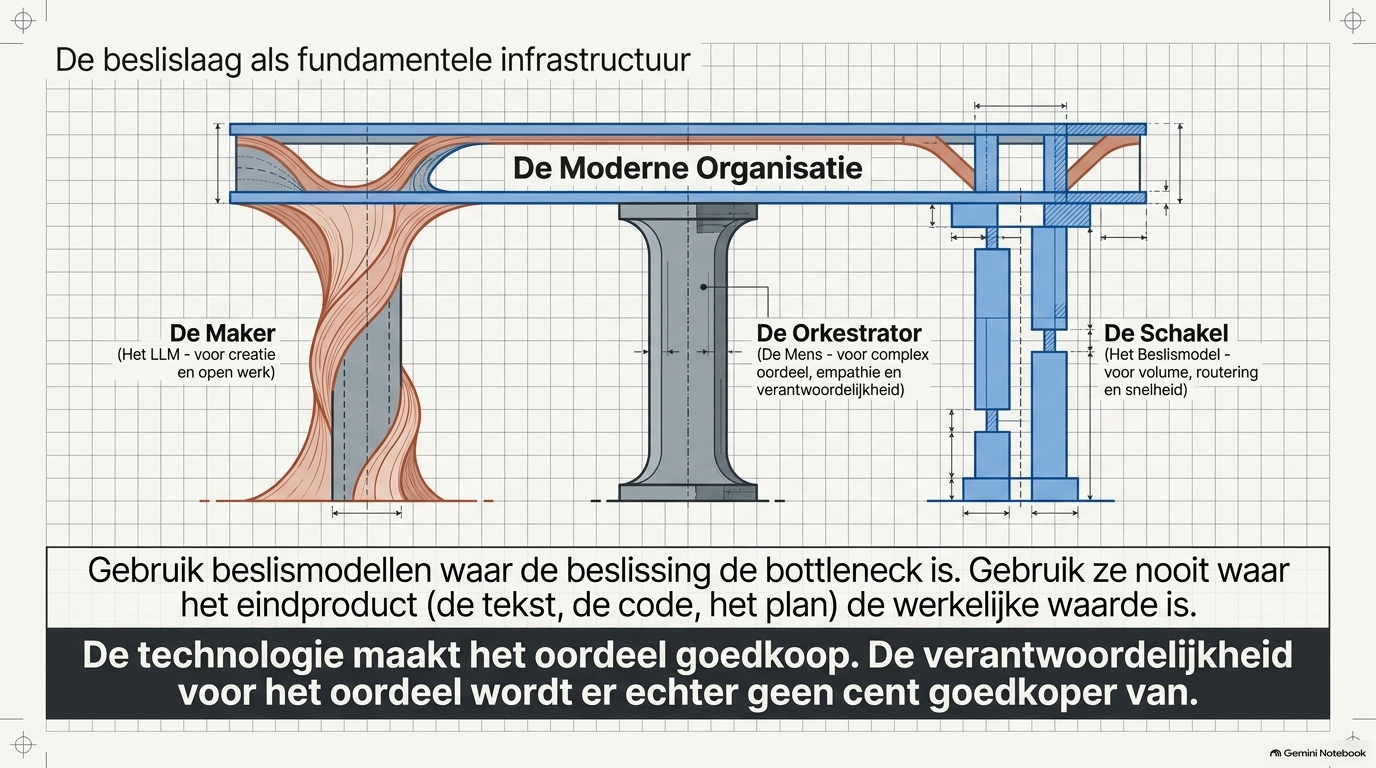
De technologie maakt het oordeel goedkoop. De verantwoordelijkheid voor het oordeel wordt er niet goedkoper van.
Bronnen
Aankondigingen en documentatie
- TypeSafe AI, Introducing System One Models & Jev, 15 september 2026. https://typesafe.ai/blog/introducing-system-one-models-and-jev
- TypeSafe AI, documentatie: Primitives en Model jaggedness: jev-1.13, geraadpleegd 9 oktober 2026. https://docs.typesafe.ai/primitives en https://docs.typesafe.ai/model-jaggedness/jev-1.13
- Vercel, Jev is the fastest-adopted model in AI Gateway history, 18 september 2026. https://vercel.com/blog/ai-gateway-jev-model-launch
- Vercel, Auto-approve tool calls with eve and Jev, geraadpleegd 9 oktober 2026. https://vercel.com/kb/guide/auto-approve-tool-calls-eve-jev
- Browser Use, jev-ultrafast, september 2026. https://github.com/browser-use/jev-ultrafast
- Von, repository met vergelijking op 49 taken, 2026. https://github.com/wfzyx/von
- Perplexity, modelkaart pplx-decider-v1-27b, 1 oktober 2026. https://huggingface.co/perplexity-ai/pplx-decider-v1-27b
Berichtgeving
- TechCrunch, A new kind of AI model from a ChatGPT inventor is thrilling developers, september 2026. https://techcrunch.com/?p=3165837
- Forbes, This $200 Million Startup Wants To Fix AI's Overconfidence Problem, 15 september 2026. https://www.forbes.com/sites/the-prompt/2026/09/15/this-200-million-startup-wants-to-fix-ais-overconfidence-problem/
- SiliconANGLE, TypeSafe AI exits stealth with $40M to build AI for use by software, 16 september 2026. https://siliconangle.com/?p=847135
- The Next Web, over de gratis periode van Jev op de AI Gateway van Vercel, september 2026.
- VentureBeat, over Jev en prompt injection, 21 september 2026.
- The Information, over de financieringsgesprekken van TypeSafe, 24 september 2026.
- The Register, Cloudflare tries to outplay Jev with open-weight Clef models, 1 oktober 2026. https://www.theregister.com/a/5300649
- SiliconANGLE, AWS debuts Strands Decider 2B, 1 oktober 2026. https://siliconangle.com/?p=848982
- ProPakistani, OpenAI launches Decisions API with up to 10x faster responses, 7 oktober 2026. https://propakistani.pk/2026/10/07/openai-launches-decisions-api-with-up-to-10x-faster-responses/
Metingen en onderzoek
- AI/ML API, What Is Jev? TypeSafe's Decision Model, Tested Against LLMs, 25 september 2026. https://aimlapi.com/blog/what-is-jev
- OpenRouter, Is Jev as Accurate as Frontier Models at Classification?, 2026. https://openrouter.ai/blog/insights/jev-vs-claude-opus-5-classification/
- LangChain, Jev-as-a-Judge for Agent Evals, september 2026. https://langchain.com/blog/jev-agent-evals-langsmith
- Deußer e.a. (Universiteit Bonn, Lamarr-Institut), Evaluating and Benchmarking the System One Model Jev, arXiv 2609.37647, september 2026. https://arxiv.org/pdf/2609.37647
- Rafe en Das (Texas State University), Benchmarking System One decision models against trained classifiers and language models for automated decision gates, arXiv 2610.00346, oktober 2026. https://arxiv.org/pdf/2610.00346
- JevOut: Natural Context Can Flip Decision Models, arXiv 2609.30243, september 2026. https://arxiv.org/pdf/2609.30243
- JEV as a Judge for Agent Trace Security: An Empirical Comparison with Generative LLM Judges, arXiv 2609.34862, september 2026. https://arxiv.org/pdf/2609.34862
- Jilin University, More Choices, Fewer Decisions: Ordinal-Scale Bias in JEV-like Direct-Decision Models, arXiv 2609.38827, september 2026. https://arxiv.org/pdf/2609.38827
- Tang en Zheng (Northeastern University), Typed Decision Models: An Early Evidence Audit and Evaluation Checklist, arXiv 2609.32160, september 2026. https://arxiv.org/pdf/2609.32160
Achtergrond
- Daniel Kahneman, Thinking, Fast and Slow, Farrar, Straus and Giroux, 2011.
- William Stanley Jevons, The Coal Question, Macmillan, 1865.
Noot: de details van de VentureBeat-test zijn ontleend aan de samenvatting van NeuralTrust (https://neuraltrust.ai/blog/jev-typesafe-ai-security). De uitspraak van DCVC over winstgevendheid en de waardering van rond de 10 miljard komen uit berichtgeving van Crypto Briefing (https://cryptobriefing.com/typesafe-ai-billion-dollar-funding-jev-model/); de kanttekening van TypeSafe over subsidie uit de samenvatting van NYU Shanghai RITS (https://rits.shanghai.nyu.edu/ai/typesafe-jev-system-one-model).
Co-creatie: dit stuk is gemaakt met Claude (Anthropic) en Grok (xAI); de visuals zijn gemaakt met Notebook (Google). De gedachten, posities en interpretaties zijn van mij.